消费级显卡部署大参数moe模型(qwen-3.8-flash-next)部署记录
一、是什么
让 125B 级 MoE 多模态大模型在单张 24GB 消费卡上以 4 路并发对外提供 OpenAI / Anthropic 双协议服务——上下文取满模型原生的 262,144,多模态开启,热态单流 ~105–130 tok/s、4 路合计 ~138 tok/s。
元信息
- 引擎版本:Strata 0.1.38(源码编译,CUDA 12.4 toolkit,sm_89)+ 社区多路batch并发合并请求 + 本地加固补丁
- 模型文件:官方固定 revision(
ed59f92)的 GGUF,IQ3_XXS 76.7 GB(3-bit 混合精度 + imatrix 校准),逐文件 SHA-256 校验 - 调用方式:
https://api.ssemarket.cn/v1|/v1/chat/completions+/v1/messages|API key 鉴权
| 词 | 一句话解释 |
|---|---|
| token(词元) | 模型读写文本的最小单位,中文 1 token ≈ 1~1.5 个汉字;tok/s = 每秒生成的 token 数。 |
| 参数 / 125B | 训练得到的约 1250 亿个数值,输入经它们计算出下一 token。 |
| MoE(混合专家) | 共 48 × 512 = 24,576 个专家子网络,每个 token 生成时仅激活 10 个,激活比 = 10/512 ≈ 2%。 |
| 路由 router | 为每个 token 计算并选出 10 个相关专家的分配模块。 |
| prefill / decode | prefill 并行读入全部输入(快);decode 逐 token 串行生成输出(慢)。 |
| KV cache | 缓存已处理 token 的 K/V 中间结果以供复用,占用随上下文线性增长(26 万 token ≈ 3.1 GB,压缩存储)。 |
| MTP / 投机解码 | 一次预测 4 个 token → 大模型批量验证 → 猜对即采纳,平均提速 1.6~1.8×。 |
| 量化(IQ3_XXS) | 每个参数用 ≈ 3 bit 存储,体积压至原版约 1/5,精度损失很小。 |
| 显存 / 内存 / 磁盘 | 三级存储:速度 显存>内存>磁盘,容量 显存<内存<磁盘,数据按需逐级搬运。 |
整体画面(一张图):
graph LR
    U["你 / AI 应用"] -->|"一句话提问"| S["服务层(8080 端口)"]
    S -->|"读题 + 答题"| M["模型大脑(GPU1)"]
    M -->|"一块一块蹦出字块"| S
    S -->|"拼成完整回答"| U
    M -.->|"手边"| G["显存:最常翻的专家 + 对话小抄"]
    M -.->|"储藏室"| R["内存:全部 24,576 个专家"]
M -.->|"书架"| D["磁盘:查表 + 模型原文件"]部署日期:2026年10月5日
二、部署方法
2.1 权重与数据准备
| 步骤 | 做法 | 关键点 |
|---|---|---|
| 模型下载 | 独立下载脚本(hf-mirror 镜像,断点续传 + 字节数 + 官方 SHA-256)→ 集市云/shared/weights/ |
通过ssemarket腾讯云主机在集市云机器下载模型 |
| MTP 草稿层 | mtp_fetch.py 按 HTTP Range 抠 31 个 mtp.* 张量(5.2 GB) |
从 360GB/131 分片的 BF16 checkpoint 里取需要的范围 |
| 校验 | pod 侧独立复核:模型 3 文件 + MTP 31/31 全部与官方一致 | 双路核对 |
2.2 引擎编译(Linux 没有官方预编译包)
- 官方 release 只有 Windows 资产 → 必须源码编译;
- 依赖 llama.cpp 源码(固定 commit):github.com 主站不通,用
codeload.github.com预置进third_party/llama.cpp/,setup 见即成全; - 主引擎 ~10 分钟;视觉编码器
strata-vision(CUDA)~15 分钟。
2.3 适配
| 问题 | 现象 | 对策 |
|---|---|---|
| /shared 只读 | setup 校验分片后要写 .done 标记 → 只读盘直接崩 |
pod 数据目录放符号链接指向 /shared:标记写本地、数据读共享、零拷贝;MTP 拷入 pod 后本地打包 |
| CPU 线程超额 → CFS 节流 | prompt 处理 5.5 tok/s(官方同档参考 1,750),累计被节流 2,242 秒 | 引擎 --pool-workers 默认"每个物理核"=76,而 cgroup 只有 16 核配额 → 改 12,节流归零 |
| 机械盘随机读 6.9 ms | PLE 查表读盘拖慢每 token | --ple-io ram 把 28.8GB 查表读进内存(mlock 因硬限 8MB 不可用,引擎自动降级为页缓存方案) |
2.4 并发:集成社区合并请求
- 本项目的开发者目标不做并发服务,于是社区的并发合并请求没有被理会
- 对pr进行独立代码审查:引擎侧无内存/越界/算术缺陷;服务端有 3 个并发生命周期缺陷;
- 本地加固补丁:①引擎重启 epoch 失效(在途批请求遇崩溃重启立即干净失败,杜绝跨请求串流)②unload 守卫 ③
/v1/status与/props报告真实槽位数 ④测试工具兼容单卡配置; - 全部改动可回滚。
三、哪一层放在哪:显存 / 内存 / 磁盘的实测分布
graph TB
    subgraph GPU1["RTX 4090 D · 24 GB 显存"]
        EC["专家缓存(自适应)≈12.8 GiB"]
        SL["批槽会话 ×4(各 0.95 GiB)<br/>QSA 常驻 KV 窗口 32768 cells + 索引器 + GDN 状态"]
        MTP["MTP 草稿层 835 MiB"]
        DEN["dense / native 投影 1,781 MiB"]
        VIS["视觉编码器 ~1.9 GiB(独立进程)"]
    end
    subgraph RAM["系统内存 100 GiB(cgroup 限额)"]
        AR["专家 arena ≈40–47 GiB(全部 24,576 个专家)"]
        KV["KV 全量 pinned 3.09 GiB(int8)"]
        PLE["PLE n-gram 表 28.8 GiB(页缓存)"]
        PK["pack / MTP 运行态 ≈2.3 GiB"]
    end
    subgraph DISK["磁盘"]
        SH["/shared 只读:模型分片 76.7 GB(符号链接接入)"]
        PKD["pack 目录:dense.bin 1.5 GB 等"]
    end
    EC <-->|"未命中经 PCIe(实测 23.4 GB/s)"| AR
PLE -.->|"每 token 16 行(内存命中)"| RAM| 层 | 放什么 | 实测数字 | 依据(启动日志/参数) |
|---|---|---|---|
| VRAM 24 GB | 专家缓存(热专家 blob 常驻) | 批前 10,243 专家 / 16.61 GiB;批 4 后自动缩至 ~12.8 GiB,实测命中 85.1% | --expert-cache auto |
| 4 个批槽会话 | 0.95 GiB/槽,共 3.8 GiB | --batch 4 启动行 |
|
| MTP 草稿层 | 835 MiB(专家 675 + dense 111) | 启动行 | |
| dense/native 投影矩阵 | 300 个矩阵 / 1,781 MiB | 启动行 | |
| 视觉编码器(独立进程) | ~1.2 GiB@1024 图像 tokens + 700 MiB 预留 | --vision --vram-reserve-mib 700 |
|
| KV 常驻窗口 | 每 QSA 层 32,768 / 262,144 cells | --kv-resident 32768 |
|
| RAM 100 GiB | 专家 arena(全量专家) | 载入 39.97 GiB(另含映射的 token embedding 260 MiB 等,总规划 ~47 GB) | 启动行(载入耗时 ~760 s) |
| KV 全量(int8,全上下文) | 3.09 GiB pinned | 启动行 | |
| PLE 查表 320,001,536 行 × 160 维 | 28.8 GiB(页缓存;mlock 不可用降级) |
--ple-io ram |
|
| 磁盘 | /shared 模型分片 | shard1 47.0 GB + shard2 28.8 GB + mmproj 0.87 GB | 符号链接接入 |
| pack / MTP | dense.bin 1.5 GB;mtp tensors 5.2 GB + rt 0.8 GB |
为什么这样分:dense 权重与热专家放显存(带宽最高);全部 24,576 个专家放内存(每个 token 只碰其中 10 个/层,命中率 85% 由缓存承担,其余走 CPU 池或 PCIe);PLE 查表,28.8GB 本部放在内存页缓存页。
四、跑起来的调度:从请求到输出的完整链路
4.1 进程与托管
graph TB
    P1["pod PID1(init)"] -->|"校验 pidfile+/proc cmdline 后自动拉起"| SUP["supervisord"]
    SUP --> SRV["serve/server.py(常驻, :8080)"]
    SRV -->|"stdin/stdout 文本管道<br/>GEN/BGEN · T/BT · BADM · DONE/BDONE · STOP/BSTOP"| ENG["engine/strata --serve"]
    SRV --> VISP["strata-vision(图像编码, GPU)"]
    ENG --> CUDA["CUDA kernels + CUDA graph(48 层/窗口)"]
    ENG --> POOL["CPU 专家池(12 workers + doorbell)"]
4.2 并发调度(重点)
- HTTP 层:
ThreadingHTTPServer全部接收,不限连接数; - 单请求独占:走 solo 路径(
GEN,带 MTP 投机解码——单流最快); - 第二请求到达:前一个请求被 STOP(引擎报
finish=cancel),无缝迁入批槽——携带"prompt + 已生成 tokens"续跑,prompt 缓存保证零重读; - 批窗口:每个 verify 窗口携带 4 个会话各一个 token——dense 权重 / 共享专家 / head 每窗口只读一遍给 4 路共用;各槽状态(GDN 递推、QSA K/V、索引器、PLE 历史)完全独立;
- 准入:一次一个(
ctl锁串行);准入期间引擎把该请求当GEN 1读完 prompt 并产出第一个 token,然后BADM 1原子转交槽位(槽位状态用 checkpoint + 全量 KV 恢复,杜绝残留污染); - 槽满(>4 并发):入口排队等空槽,不拒绝;断开:
BSTOP让该槽在下一窗口干净收尾,其他槽继续; - 加固:引擎崩溃自动重启时,在途请求立即干净失败(503 + 原因),不串流、不挂死(epoch 机制);卸载接口在有请求时拒绝执行(实测见第六节)。
stateDiagram-v2
    state "空闲:进程常驻待命,等第一个请求" as S0
    state "solo 独跑:单流最快,MTP 草稿全开" as S1
    state "批槽并行:每窗口 4 路各推进 1 块" as S2
    state "门口排队:槽满不拒绝、不丢请求" as S3
    [*] --> S0
    S0 --> S1: 第 1 个请求进门
    S1 --> S2: 第 2 个请求到达:老请求被 STOP 携已生成内容迁入槽位
    S2 --> S2: 一个窗口一轮,直到有槽写完
    S2 --> S3: 第 5 个请求到达(4 槽全占)
    S3 --> S2: 有空槽释放(BDONE 正常收尾 / BSTOP 断连收尾)
    S2 --> S0: 全部写完
4.3 CPU 专家池与自适应缓存(引擎内部调度)
- 路由出 10 个专家 id 后写 pinned “doorbell”,CPU 自旋收到立刻分流:显存命中→GPU 算;部分未命中→PCIe DMA(实测 23.4 GB/s);其余→CPU 就地算(AVX-512 内核,12 worker 池);
- 专家缓存自适应换入(按实际路由统计),不做 LRU 淘汰;本部署实测命中 85.1%;
RouterLookahead用下一层路由结果预取。
graph TD
    RT["Router:512 个专家里挑 10 个"] --> DB["按铃:把专家名单写到 pinned 共享便签"]
    DB --> Q{"这位专家此刻在哪?"}
    Q -->|"约 85%:显存缓存里"| GV["GPU 直接算"]
    Q -->|"部分未命中"| PC["PCIe 搬进显存<br/>实测 23.4 GB/s"]
    Q -->|"其余"| CP["CPU 池就地算<br/>AVX-512 内核 · 12 worker"]
    GV --> OUT["叠加公共专家 → 交给下一层"]
    PC --> OUT
    CP -->|"结果放回共享便签"| OUT
4.4 调度时序图(UML):一个请求从进门到进槽
sequenceDiagram
    autonumber
    participant C as 客户端
    participant S as 服务层(server.py)
    participant E as 引擎(strata)
    participant G as GPU1 + 内存

    C->>S: POST /v1/chat/completions(带 API key)
    S->>S: 验 key → 套聊天模板 → 切成字块<br/>(带图:先交 strata-vision 编码)
    alt 此刻没有别人在跑(独占)
        S->>E: GEN(读题 + 答题,允许打草稿)
    else 已有请求在跑(进批槽)
        S->>E: BGEN 槽位N(先按"独占读一次"把题读完<br/>并产出第一块)
        E-->>S: BADM 1("已转入槽位N")
        Note over S,E: 原来的独占请求会收到 STOP,<br/>无缝搬进另一个槽位继续写(不重读题)
    end
    loop 每块字块产出
        E-->>S: T / BT 槽位N(一块)
        S-->>C: 流式(SSE)推送这一块
    end
    alt 出现第 5 个并发(槽满)
        Note over S: 在门口排队等空槽,不拒绝、不丢请求
    end
    alt 客户端中途断开
        S->>E: BSTOP 槽位N(该槽这轮收尾后释放,其它槽不受影响)
    end
    E-->>S: DONE / BDONE(结束 + 统计)
    S-->>C: 收尾(usage、结束标记)
五、一个 token 生成,经过了什么
以一次对话请求为例(标 ✦ 的是本部署的配置点):
图 1:总览(先看这张定位)
flowchart LR
    S1["① 入口与调度<br/>鉴权 · 模板 · 视觉 · 选路"] --> S2["② Prefill<br/>分块读入 · 写 KV · PLE 查表"]
    S2 --> S3["③ Decode:48 层<br/>注意力 · 路由 · 专家"]
    S3 --> S4["④ 采样与提交<br/>MTP · 采样 · commit"]
    S4 --> S5["⑤ 回传<br/>T / BT · SSE / JSON"]
    S4 -. "还有 token,逐 token 循环" .-> S3
图 2:入口、鉴权与 solo/批槽选路
flowchart TB
    client(["客户端"]) --> http["HTTP :8080"]
    http --> auth{"api key 鉴权"}
    auth -- "失败" --> e401["返回 401,拦截请求"]
    e401 --> client
    auth -- "通过" --> svc["服务层 Service.run"]
    svc --> tpl["Jinja 渲染模型自带聊天模板<br/>(含思考档位指令)"]
    tpl --> tok["tokenize 分词"]
    tok --> img{"含图片?"}
    img -- "是" --> vis["strata-vision 视觉编码<br/>单图 → 1024 图像 tokens"]
    img -- "否" --> sched
    vis --> sched{"generate_batched<br/>并发调度"}
    sched -- "当前无伴跑请求(独占)" --> solo["发「GEN max_new ids」"]
    sched -- "已有请求在跑(批槽模式)" --> bgen["抢一个空槽(共 4 槽)<br/>发「BGEN slot max_new ids」"]
图 3:Prefill(读题)与批槽交接
flowchart TB
    in(["引擎 receive:GEN / BGEN ids"]) --> split["Prompt 按 8,192 token 分块<br/>走批量 prefill 路径"]
    split --> block["逐块经过 48 层"]
    block --> kvw["写入 KV:显存常驻窗口 +<br/>pinned RAM 全量(int8,3.09 GiB)"]
    block --> ple["PLE:每 token 按 3-gram 查 16 行<br/>命中内存页缓存(28.8 GiB,不读机械盘)"]
    kvw --> q{"是否 BGEN?"}
    ple --> q
    q -- "否(solo)" --> dec0["直接进入解码窗口"]
    q -- "是(BGEN)" --> first["prefill 读到第一个 token"]
    first --> hand["回「DONE」+「BADM slot 1」"]
    hand --> restore["服务端一次性转交槽位状态<br/>checkpoint + KV 全量恢复"]
    restore --> dec1["并入槽位流,进入解码窗口"]
图 4:Decode 每一步的 48 层内部(CUDA graph 捕获回放)
flowchart TB
    st(["解码一步开始"]) --> loop["进入下一层(48 层逐层串行)"]
    loop --> hc["a) hyper-connection 读取<br/>norm / down / up 三段"]
    hc --> type{"判断本层类型?"}
    type -- "GDN 层(共 36 层)" --> gdn["卷积 + 递推更新<br/>固定大小状态存于各槽 session"]
    type -- "QSA 层(共 12 层)" --> idx["索引器 append"]
    idx --> score["block 打分 → top-k 选块"]
    score --> attn["注意力计算:KV 先取显存常驻窗口 32,768 cells<br/>溢出部分从 pinned RAM 流式读取"]
    gdn --> rte
    attn --> rte["c) Router:512 专家打分 → top-10"]
    rte --> shared["共享专家:每层必算"]
    rte --> hit{"d) 10 个路由专家<br/>显存缓存命中?"}
    hit -- "命中 ~85%" --> vram["直接在显存计算"]
    hit -- "未命中 ~15%" --> way{"搬运方式"}
    way -- "CPU 池" --> cpu["doorbell + AVX-512 在 CPU 算<br/>(权重留在内存)"]
    way -- "PCIe" --> pcie["经 PCIe(实测 23.4 GB/s)搬进显存再算"]
    shared --> merge
    vram --> merge
    cpu --> merge
    pcie --> merge["本层专家输出加权合并"]
    merge --> head["e) 输出头 head → logits"]
    head --> nxt{"还有下一层?"}
    nxt -- "是,进入下一层" --> loop
    nxt -- "否,48 层走完" --> en(["交采样 / MTP 验证"])
图 5:解码窗口外的 MTP、采样、提交与回传
flowchart TB
    win(["解码窗口:本步生成 1 个 token"]) --> layers["48 层前向(见图 3)→ logits"]
    layers --> mode{"solo 请求?"}
    mode -- "是" --> mtp["MTP 草稿层(835 MiB 常驻显存)<br/>一次提 4 个草稿 token"]
    mtp --> verify["一个窗口批量验证<br/>草稿接受率 ~65%,加速 1.6–1.8×"]
    verify --> sample
    mode -- "否(批槽)" --> sample["采样:贪心(默认)<br/>或 Philox(seed, position),各槽按行独立"]
    sample --> commit["Commit:KV append / 索引器推进 /<br/>GDN 状态递进 / PLE 历史推进<br/>(批槽 commit 图紧随窗口,无需主机决策)"]
    commit --> more{"还有 token 要生成?"}
    more -- "是" --> win
    more -- "否" --> back["回传:solo「T id」/ 批槽「BT slot id」<br/>→ 服务端组装"]
    back --> rfmt{"返回方式"}
    rfmt --> sse["SSE 流式"]
    rfmt --> jpkg["整包 JSON"]
    sse --> done(["回客户端<br/>usage / 统计随行"])
jpkg --> done每窗口读的权重:dense+共享专家+head 只读一遍。
5.1 时序图(UML):一个 token 的诞生(独占模式)
sequenceDiagram
    autonumber
    participant S as 服务层
    participant H as 引擎主线程
    participant G as GPU1(显存)
    participant P as CPU 专家池(12 线程)
    participant R as 内存(专家仓库 + 小抄)

    S->>H: GEN(题目的所有字块)
    Note over H: 读题阶段:一次 8,192 块地整段读完<br/>(每块都记进 KV 小抄;本部署查表已在内存)
    Note over H,G: 之后进入答题循环,下面每转一圈 = 产出 1 块
    loop 48 层逐层过(整套动作事先录成 CUDA graph,逐层"回放")
        H->>G: 本层输入
        G->>G: 通道混合(Hyper-Connection:把上一层的汇总重新分配)
        alt 36 个线性注意力层(DeltaNet)
            G->>G: 递推更新,各层自带"记忆状态"
        else 12 个稀疏注意力层(QSA)
            G->>G: 拿当前问题给 KV 小抄打分,只取最相关的部分
            R-->>G: 常驻显存之外的老小抄从内存流入
        end
        G->>G: 分诊:512 个专家里挑 10 个
        alt 专家在显存缓存里(实测约 85%)
            G->>G: 直接计算
        else 未命中
            G-->>P: 按门铃(把要算的专家名单放到共享便签)
            P->>R: 从内存取这 10 个专家的权重
            P->>P: 用 AVX-512 就地算完(CPU 顶上一部分干活)
            P-->>G: 结果放回共享便签
        end
        G->>G: 叠加"公共专家"→ 交给下一层
    end
    G->>G: 输出头:算出"下一个字块"的候选分数表
    alt 独占模式下启用草稿(MTP)
        Note over G: 小助手先一口气猜 4 块 → 大模型一次验算 4 块<br/>→ 平均收下 2.4–3.2 块(实测接受率约 65%)
    end
    G-->>H: 选出一个字块(贪心取最高分 / 按种子做可复现的随机)
    H->>R: 记账:小抄补一页、各层记忆与查表指针前移
    H-->>S: 通过管道发出这一块(T)
    S-->>S: 组装成 SSE 流 / JSON 发回客户端
5.2 时序图(UML):4 路共享一个窗口(批槽模式)
sequenceDiagram
    autonumber
    participant S as 服务层
    participant E as 引擎(批窗口调度)
    participant G as GPU1
    participant A as 槽1 会话
    participant B as 槽2 会话
    participant C as 槽3 会话
    participant D as 槽4 会话

    loop 每个窗口(四路各推进 1 块)
        S-->>E: 4 个槽各带 1 个待处理字块(带着各自的进度)
        E->>G: 一个窗口一起算(4 行同过 48 层)
        Note over G: dense 权重、公共专家、输出头只读一遍,4 路分摊<br/>各槽的 KV 小抄 / 注意力记忆 / 查表历史完全独立
        G-->>E: 每槽选出 1 个字块
        E-->>A: BT 1
        E-->>B: BT 2
        E-->>C: BT 3
        E-->>D: BT 4
        E-->>S: (各槽的块分别回给各自客户端)
    end
    Note over E: 某一槽写完了 → BDONE 释放,门口排队的请求补位;<br/>新请求先"独占读一次题"再并入(不重读)
六、实测性能与可靠性
6.1 并发吞吐:
| 并发 | 每路 tok/s | 合计 tok/s |
|---|---|---|
| 1(solo,含 MTP) | 76.8 – 88.1 | — |
| 2 | 52.0 – 55.8 | 104 – 110(+26~35%) |
| 4 | ~34.8 | 137.5 – 138.2(+56~80%) |
| 带图请求 | 37.4 | — |
基准测试台复测(1/2/4/6/8/12 路 × 3 轮,每路生成 ~256 token):
| 并发 | 每路 tok/s | 总吞吐 tok/s | TTFT 中位/均值 |
|---|---|---|---|
| 1 | 76.4 | 74.4 | 0.63s / 0.68s |
| 2 | 35.2 | 67.2 | 0.90s / 1.28s |
| 4 | 20.4 | 76.9 | 2.68s / 2.23s |
| 6 | 17.0 | 73.3 | 2.77s / 5.36s |
| 8 | 15.5 | 83.8 | 9.83s / 7.38s |
| 12 | 13.1 | 86.1 | 12.12s / 12.01s |
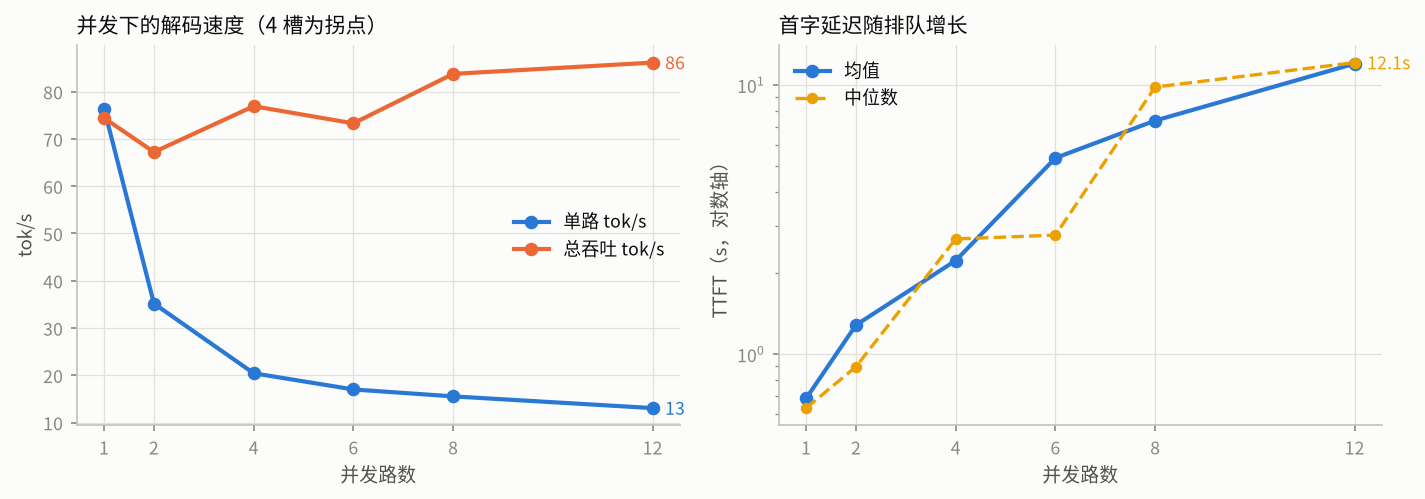
- 2Hz 采样显示 GPU1 利用率在全部档位 80–100%——系统是 GPU 饱和的:总吞吐 67~86 tok/s 即当前条件的实际上限,加并发只买排队(>4 路每多一波 TTFT +~5s)。
- 复测绝对值比验收时低约 40%(同机 GPU0 有邻居满载,MPS 共享);采样已排除 CPU 节流(0)、磁盘读(0)和外部请求混入,相对结论可信、绝对值按 ±20% 看待。
- 冷启动首个请求 8.5 tok/s(首次触达页/专家缓存),渐热 22.9 → 稳态;重启后模型载入 ~6–13 分钟(本盘共享 I/O 限制)。
6.2 上下文长度:预填充线性增长,解码速度几乎不变
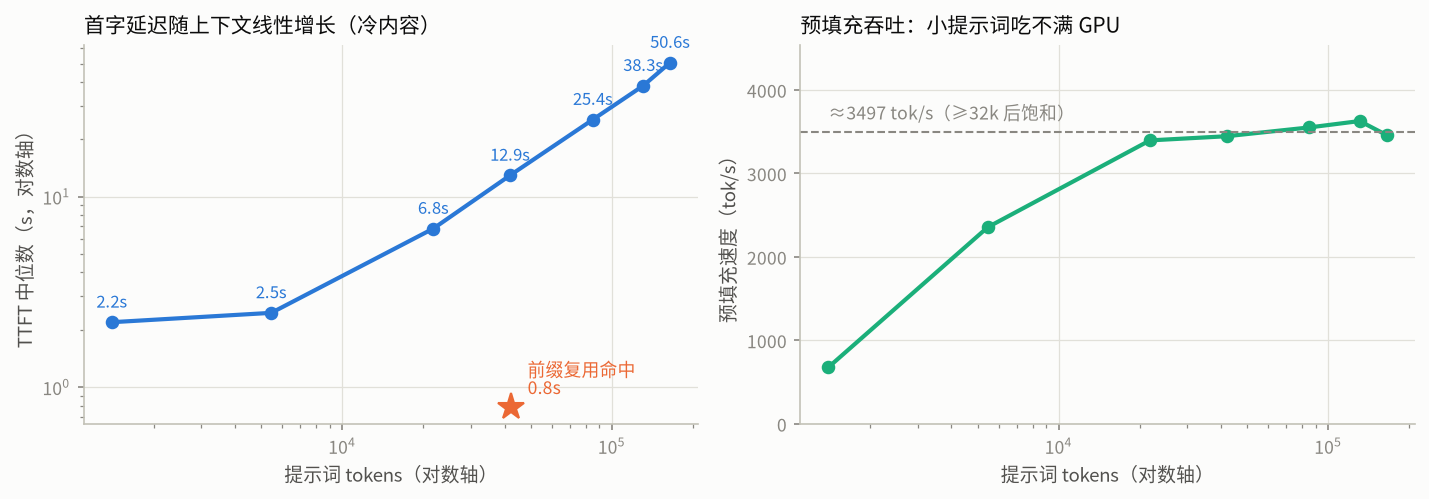
预填充(TTFT)随提示词长度线性(单路、冷内容、唯一前缀防缓存假象):
| 实测 prompt tokens | 1 398 | 5 458 | 21 794 | 41 958 | 85 137 | 130 840 | 164 618 |
|---|---|---|---|---|---|---|---|
| TTFT | 2.19s* | 2.45s | 6.80s | 12.94s | 25.42s | 38.27s | 50.62s |
| 预填充速度 | 678 | 2 357 | 3 397 | 3 446 | 3 552 | 3 628 | 3 461 tok/s |
* 空闲后第一问含冷启动代价。线性拟合:TTFT ≈ 0.4s + prompt_tokens / 3 350,250k 以内无拐点。小提示词吃不满 GPU,≥32k 后稳定在 ~3.5k tok/s。
前缀复用优化:同一 64k 提示词第二次请求,TTFT 13.4s → 0.79s(17×)(服务端记 reused 42k tokens)——多轮会话天然享受这个收益。
graph LR
    A["同一段 64k 提示词"] --> B{"服务端还留着这段前缀吗?"}
    B -->|"第一次:没有"| C["整段重新预填充<br/>TTFT 13.4s"]
B -->|"第二次:留着"| D["只补新增 token<br/>TTFT 0.79s —— 快 17 倍"]解码速度几乎不受上下文长度影响(固定生成 512 token,逐 token 时间戳口径):
| 上下文 tokens | 48 | 1 088 | 4 494 | 17 020 | 67 855 | 134 524 | 202 912 | 257 899 |
|---|---|---|---|---|---|---|---|---|
| 稳态解码 tok/s | 95.6 | 106.1 | 104.2 | 103.1 | 96.8 | 96.6 | 89.5 | 87.8 |
| TTFT | 0.8s | 2.0s | 2.5s | 6.3s | 20.3s | 40.4s | 62.5s | 81.6s |
- 长度涨 250 倍,解码只降 17%;MTP 草稿接受率全程 55~62% 不退化。长上下文"慢"的全部来源是预填充——258k 要等 82 秒才出第一个字。
- 短上下文长生成的最优口径(2048 token ×3):稳态 106~113 tok/s、滑窗峰值 150+、草稿接受率 65%。
- 读表口径:
completion_tokens会把 TTFT 摊进来(250k 时显示 5.9 tok/s,实际解码 87.8);正确算法见 6.9。
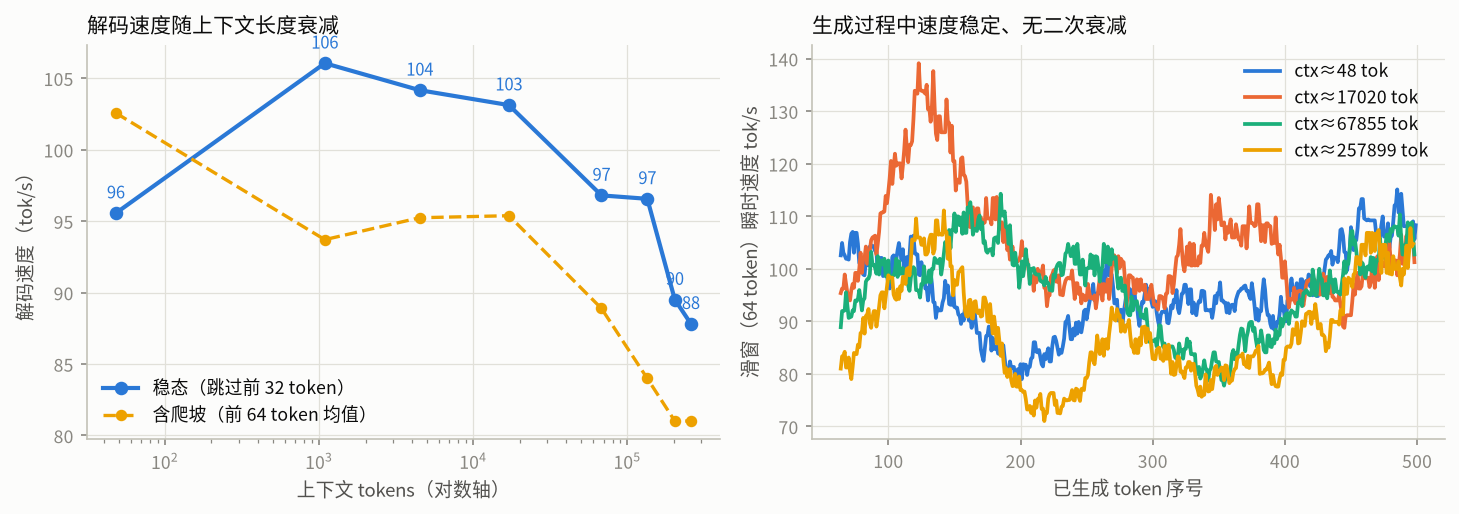
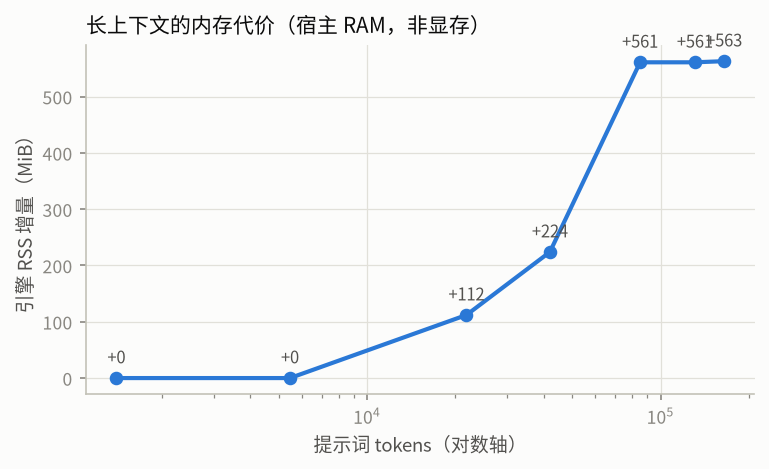
内存代价在 RAM 不在显存:引擎 RSS 86.9 → 87.6 GiB(250k 时 +560 MiB),VRAM 余量全程 428 MiB 不变——KV int8 流式放内存成立。
6.3 多模态与工具调用的开销
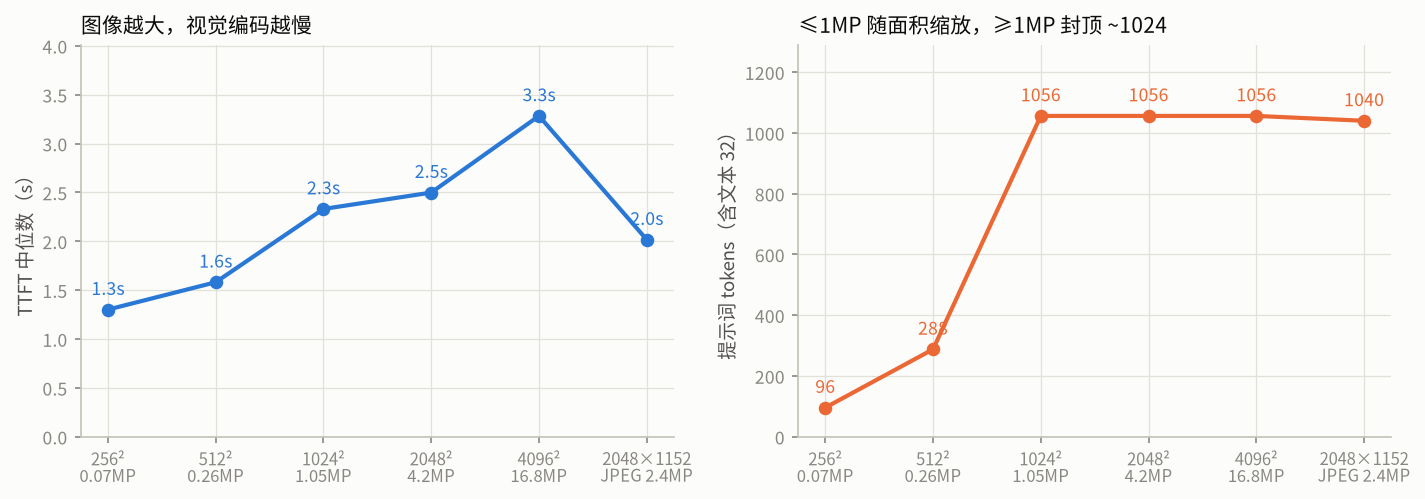
图片 token 随分辨率缩放,≥1MP 封顶 ~1024:
| 合成图 | 256² | 512² | 1024² | 2048² | 4096² | 2048×1152 JPEG |
|---|---|---|---|---|---|---|
| prompt tokens(含文本 32) | 96 | 288 | 1 056 | 1 056 | 1 056 | 1 040 |
| TTFT | 1.30s | 1.58s | 2.33s | 2.50s | 3.28s | 2.02s |
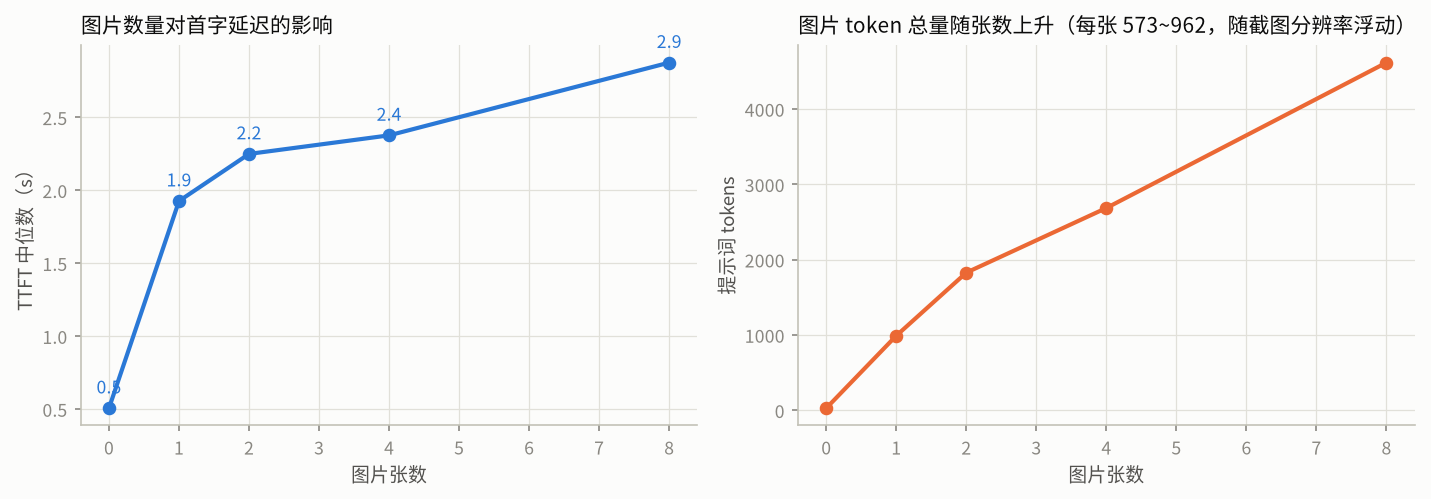
图片(0.08–1.9 MP)每张 573~962 token;第 1 张 +1.4s,之后每张只 +0.1~0.2s(8 张共 +2.4s)——视觉编码器冷启动占大头,压缩大图不省 token 但会拖慢编码(4096² 比 1024² 慢 ~1s)。
工具 schema 直接进 prompt,每个工具 ≈ +100~170 tokens:
| 工具数 | 0 | 1 | 5 | 25 | 10(长描述) |
|---|---|---|---|---|---|
| prompt tokens | 43 | 340 | 682 | 2 594 | 1 714 |
| TTFT | 0.57s | 1.35s | 1.55s | 2.54s | 1.86s |
多轮工具 loop(4 轮):prompt 959 → 1 304 tokens,TTFT 0.66~2.29s(前缀缓存覆盖增长);并行工具调用(一次多个 call)实测正常。
6.4 思考档与长生成稳定性
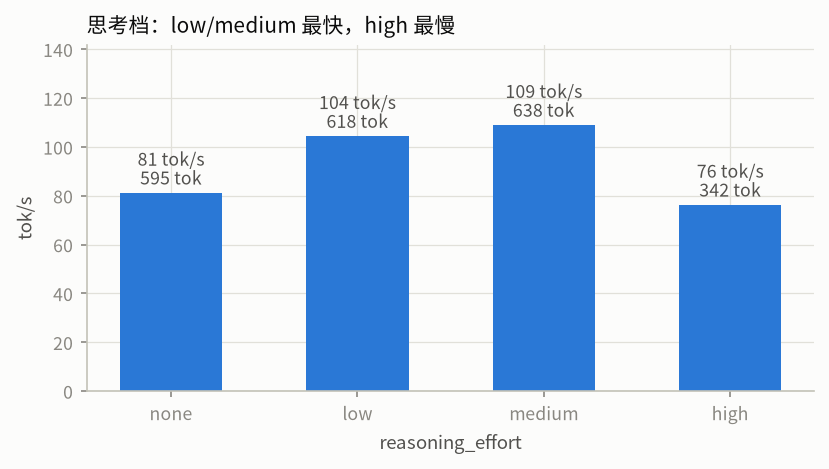
| reasoning_effort | tok/s | 生成 tokens | 思考字符数 |
|---|---|---|---|
| none | 81 | 595 | 0 |
| low | 104 | 618 | 353 |
| medium | 109 | 638 | 296 |
| high | 76 | 342 | 393 |
- low/medium 反而比 none 快(指令风格影响草稿接受率),high 最慢也最深。
- 思考 token 计入
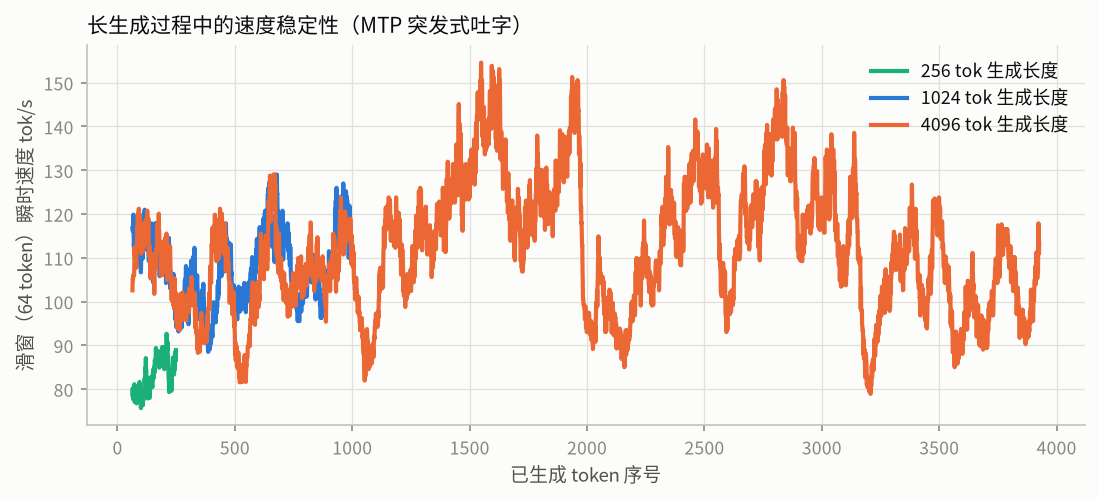
max_tokens:high 档 342 个 token 中大部分是思考,带思考时max_tokens建议 ≥1024。 - 长生成(2048~4096 token)滑窗瞬时速度 80~155 tok/s、中位 ~115,无系统性衰减;前 ~200 token 是草稿爬坡段。
6.5 综合场景:多轮会话 与 并发长上下文
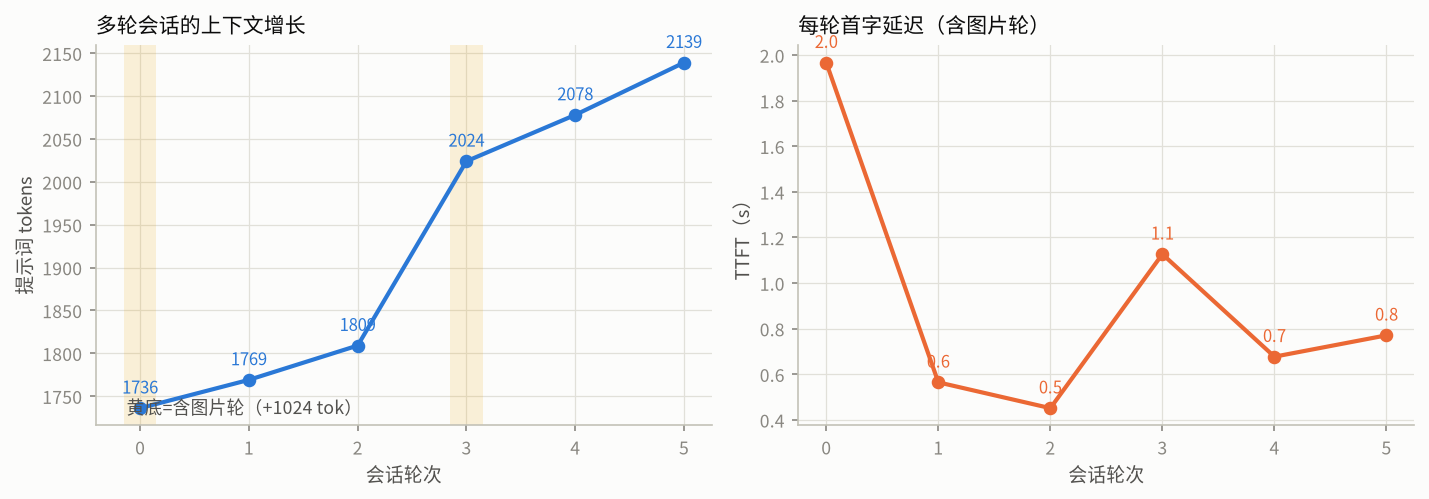
多轮图文+工具会话(6 轮):prompt 1 736 → 2 139 tokens(图片轮每张 +1024),每轮 TTFT 0.45~2.0s(图片轮最贵),前缀缓存让后续轮几乎免预填充。
并发 × 长上下文(最坏情况,单路 TTFT 作对照:32k=6.8s / 64k=12.9s):
| 场景 | 逐请求 TTFT | 解码 | 总吞吐 |
|---|---|---|---|
| 2 × 32k | 13.1s | 1.4 tok/s | 2.7 tok/s |
| 4 × 32k | 23.7s | 0.9~21 tok/s | 3.5 tok/s |
| 4 × 64k | 19.0 / 40.4 / 60.2 / 81.5s | 0.4 tok/s | 1.5 tok/s |
| 6 × 64k | 20.9 / 40.6 / 61.8 / 82.8 / 103.8 / 124.3s | 0.3 tok/s | 1.5 tok/s |
- 预填充在并发下串行化:4/6 路 64k 的 TTFT 恰好以 ~20.5s 等距排开(单路 12.9s,争抢下 ~20.5s/个)。
- 预填充进行时解码被饿死(0.3~1.4 tok/s)——长上下文请求会拖住所有在途会话,agent 场景务必错峰提交。
6.6 资源水位
| 指标 | 实测 | 说明 |
|---|---|---|
| GPU1 显存余量 | 恒定 428 MiB | 上下文 / 图片 / 并发都不改变 |
| GPU1 利用率 | 80~100% | 全程饱和(唯一瓶颈) |
| 引擎 RSS | 86.9 → 87.6 GiB | 随上下文缓慢增长 |
| cgroup 内存 | 峰值 99.6 / 100 GiB | 无余量(风险见第九节) |
| CPU 节流 | ~0 | --pool-workers 12 修复持续有效 |
| 引擎磁盘读 | 0 MiB | PLE 全在页缓存,本批实验未触发磁盘瓶颈 |
6.7 正确性与健壮性
| 测试 | 结果 |
|---|---|
| 逐 token 一致性 | 4 会话 vs 单路 IDENTICAL ×4 |
| 超槽(5 路 vs 4 槽) | 第 5 个等空槽,5 个回答全部对题、无串流 |
| 断连(流式中途断开) | 紧随请求干净(无前请求内容) |
崩溃注入(在途批请求时 kill -9 引擎) |
全部请求干净快速失败(503+原因);挂起的慢客户端连接干净关闭、零串流;自动重启 418 s 恢复 |
| 鉴权/多模态/状态端点 | 401 正常;图像识别 5.7s 全对;concurrency: {serving: 4} |
sequenceDiagram
    autonumber
    participant C1 as 客户端 B/C(批槽在途)
    participant C2 as 慢客户端 A(读一半暂停)
    participant S as 服务层
    participant E as 引擎 strata
    participant SUP as supervisord
    Note over E: 测试注入:kill -9
    S--xC1: 立即干净失败:503 + 原因(EngineDied)<br/>不串流、不挂死
    Note over S,C2: 恢复读取时:连接被干净关闭、零串流
    SUP->>E: autorestart 拉起新实例
    Note over E: 重新载入模型 ~418 s(约 7 分钟)
    C1->>S: 新请求(新 epoch)
    S->>E: GEN
    E-->>C1: 正常回答 ✓
6.8 已知限制
引擎/服务(部署期发现)
- 批槽内不带 MTP 草稿(1 token/窗口,这就是 solo 更快的原因);惩罚类采样参数在批槽不生效;
- 生产档
--pcie-frac自适应:输出连贯,但理论上与单路轨迹不完全一致(要绝对一致需两个精确档开关,会慢); - 扩展字段
timings并发下偶发缺失/错挂(choices/usage 核心字段正确); - 单个批窗口错误会终止引擎(错误后自动重启恢复);未配
engine_silence_s; - 本盘随机读 6.9ms(机械盘级)、共享 I/O——冷话题首问慢、批量任务(如归档上传)会抢盘。
可观测性(基准测试发现)
- 批槽模式下
/metrics每批只留一条请求记录(engine.last共享),且并发时decode_tok_s字段会出现假值——并发场景的每请求指标必须以客户端口径为准; - 请求体不带
stream: true时服务端整包返回(非流式),TTFT == 总时长,测速时容易误读; - 预填充速度与内容缓存命中强相关:冷内容 ~3.5k tok/s,命中前缀时快一个数量级(13.4s → 0.79s)——基准数字必须标注冷/热口径。
6.9 基准测试方法
测试目录为 ~/bench:异步流式客户端(逐 token 时间戳、工具调用累积、非流式回退兼容)+ 2Hz 系统采样器(nvidia-smi / 进程 RSS+IO / cgroup / 服务端 /metrics 对账)+ 10 个场景定义(并发 / 上下文 / 解码 / 图片×2 / 工具×2 / 思考 / 长生成 / 综合 / 并发长上下文)。
本文复刻自 iWiki 原文:消费级显卡部署大参数moe模型(qwen-3.8-flash-next)部署记录